Inférence
Serveur d’inférence NVIDIA Triton
Déployez, exécutez et faites évoluer l’IA pour n’importe quelle application sur n’importe quelle plateforme.
Exploitez l'inférence avec toutes vos charges de travail d’IA
Exécutez des procédures d’inférence sur des modèles entraînés d’apprentissage automatique ou de Deep Learning à partir de n’importe quel framework et sur tout type de processeur (GPU, CPU ou autre) grâce au serveur d'inférence NVIDIA Triton™. Composant de la plateforme d'IA de NVIDIA et disponible via NVIDIA AI Enterprise, le serveur d’inférence Triton est un logiciel open-source qui standardise le déploiement et l’exécution des modèles d’IA avec toutes les charges de travail.
Avantages du serveur d’inférence Triton

Compatibilité avec tous les frameworks d’entraînement et d’inférence
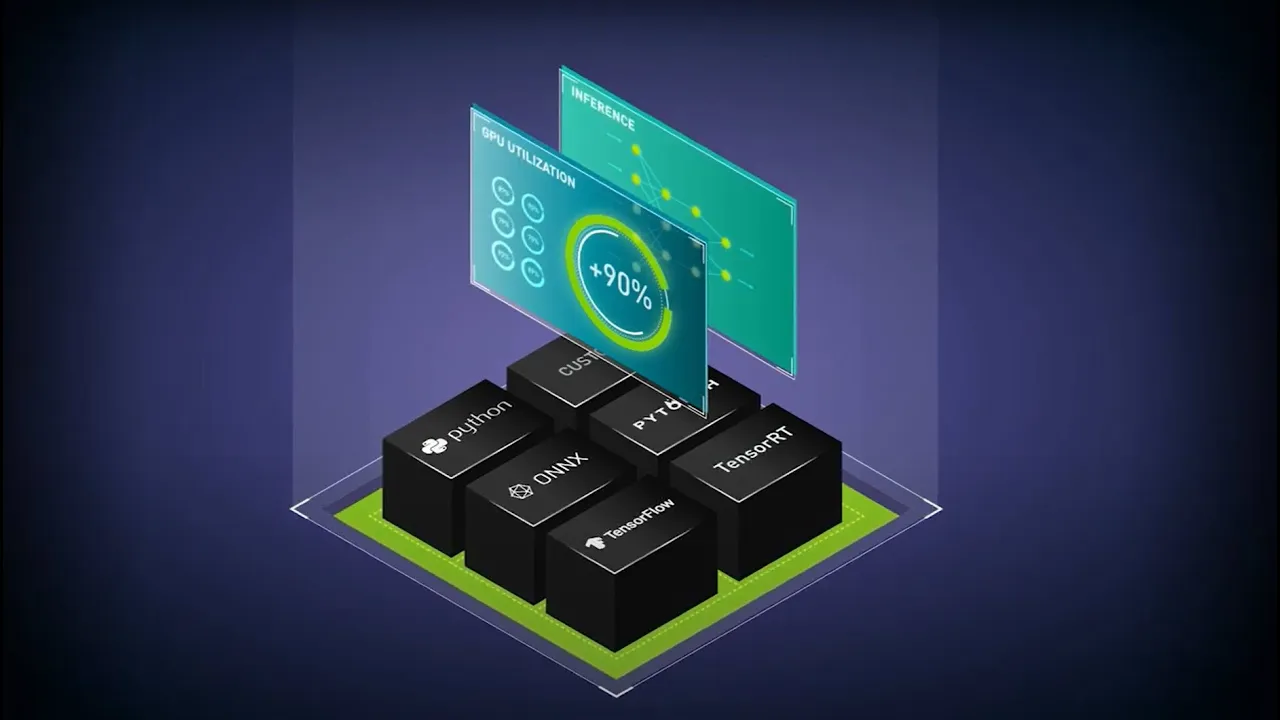
Déployez vos modèles d’IA sur n’importe quel framework majeur avec le serveur d’inférence Triton, notamment TensorFlow, PyTorch, Python, ONNX, NVIDIA® TensorRT™, RAPIDS™ cuML, XGBoost, scikit-learn RandomForest, OpenVINO, custom C++ et bien plus encore.

Inférence à hautes performances sur toutes les plateformes
Maximisez le rendement et l’utilisation de vos ressources avec des fonctionnalités avancées de batching dynamique, d’exécution simultanée, de configuration optimale et de streaming audio ou vidéo. Le serveur d’inférence Triton prend en charge l’ensemble des GPU de NVIDIA, les CPU x86 et ARM ainsi que AWS Inferentia.

Philosophie open-source et conception DevOps/MLOps
Intégrez le serveur d’inférence Triton à des solutions DevOps et MLOps telles que Kubernetes pour la mise à l’échelle et Prometheus pour la supervision. Vous pouvez également l’utiliser avec les principales plateformes d’IA et de MLOps sur site ou dans le Cloud.

Fonctionnalités de sécurité, de gestion et de stabilité d'API pour les entreprises
NVIDIA AI Enterprise, qui comprend le serveur d’inférence NVIDIA Triton, est une plateforme logicielle d’IA sécurisée et prête pour la production qui a été conçue pour accélérer le délai de retour sur investissement avec des fonctionnalités avancées d’assistance, de sécurité et de stabilité d’API.
Découvrez les fonctionnalités et les outils du serveur d’inférence NVIDIA Triton

Inférence avec de grands modèles de langage
Triton fournit une faible latence et un rendement élevé pour l’inférence avec les LLM. Il prend en charge TensorRT-LLM, une bibliothèque open-source pour la définition, l’optimisation et l’exécution des LLM pour l’inférence en production.

Ensembles de modèles
Les ensembles de modèles Triton vous permettent d’exécuter des charges de travail d’IA avec une multitude de modèles, de pipelines et d’étapes de pré et post-traitement. Votre environnement Triton est ainsi en mesure d'exécuter différentes parties de l’ensemble sur CPU ou GPU et autorise le recours à de multiples frameworks au sein d’un ensemble.

NVIDIA PyTriton
PyTriton permet aux développeurs Python de mettre en œuvre Triton avec une seule ligne de code et de s’en servir pour exécuter des modèles, des fonctions de traitement simples ou des pipelines d’inférence entiers afin d’accélérer le prototypage et les tests.

Analyseur de modèles de NVIDIA Triton
L'analyseur de modèles vous permet de déterminer plus rapidement la configuration optimale pour le déploiement d’un modèle, notamment en termes de taille de batch, de précision et d’instances simultanées. Cet outil vous aide à choisir la meilleure configuration pour répondre à différents besoins en matière de latence, de rendement et de mémoire.
Adoptants majeurs dans tous les secteurs
-
Clients
-
Intégrations d'écosystèmes


Démarrez avec NVIDIA Triton
Ayez recours aux outils appropriés pour déployer, exécuter et faire évoluer n’importe quelle application d'IA sur n’importe quelle plateforme.
Commencez à développer avec du code ou des conteneurs
Si vous souhaitez accéder au code open-source et aux conteneurs de Triton à des fins de développement, deux options gratuites s’offrent à vous :
Essayez avant d’acheter
Pour les entreprises qui souhaitent tester Triton avant d’acheter des produits NVIDIA AI Enterprise pour la production, deux options s’offrent à vous :
Ressources
-
Vidéos
-
Formations
-
Articles
-
Sessions
-
Études de cas
-
Communauté


Étapes suivantes
Vous voulez vous lancer ?
Ayez recours aux outils appropriés pour déployer, exécuter et faire évoluer n’importe quelle application d'IA sur n’importe quelle plateforme, ou accédez à d'autres ressources de développement.
Contactez-nous
Discutez avec un spécialiste des produits NVIDIA pour savoir comment passer du stade de pilote à la phase de production en bénéficiant de la sécurité, de la stabilité d'API et du support de NVIDIA AI Enterprise.
Suivez l'actualité du serveur d’inférence NVIDIA Triton
Inscrivez-vous pour recevoir les dernières informations et annonces de NVIDIA.